

Hogyan működik a ChatGPT? Nyelvi modell a válaszok mögött
Archív bejegyzés, szerkesztett tartalommal
A ChatGPT beszélgetőfelülete mögött működő nyelvi modellek szöveges mintázatokat tanulnak, majd a kapott kontextus alapján állítanak elő választ. Nem egyszerűen előre megírt mondatokat keresnek egy adatbázisban. A pontos képességek az alkalmazott modelltől és az elérhető eszközöktől függnek; egy régi GPT-verzió leírása nem azonos a teljes mai szolgáltatással.
Tokenek, transzformerek és figyelem
A szöveg tokenekre, vagyis kisebb szövegegységekre bomlik. Egy token nem feltétlenül teljes szó. A GPT-család alapvető tanítási feladata a következő token előrejelzése. A transzformer figyelmi mechanizmusa a kontextus különböző részei között tanul kapcsolatokat. A query, key és value vetületekből számított súlyok segítségével különböző információk eltérő szerepet kapnak; több figyelmi fej többféle kapcsolatot kezelhet. A klasszikus GPT-leírás dekóderjellegű architektúrára épül, ezért nem pontos azt állítani, hogy minden GPT-modell külön teljes kódolót és dekódolót használ.
A tanítás és az emberi visszajelzés szerepe
Az előtanítás nagy mennyiségű adatból tanul általános mintázatokat. Az utólagos finomítás és a visszajelzések segíthetnek az utasítások követésében, a hasznosságban és a biztonságban. A tanult paraméterek azonban nem jelentik azt, hogy a modell minden válaszát megérti vagy ellenőrizte. A gördülékeny szöveg téves következtetést és kitalált forrást is tartalmazhat.
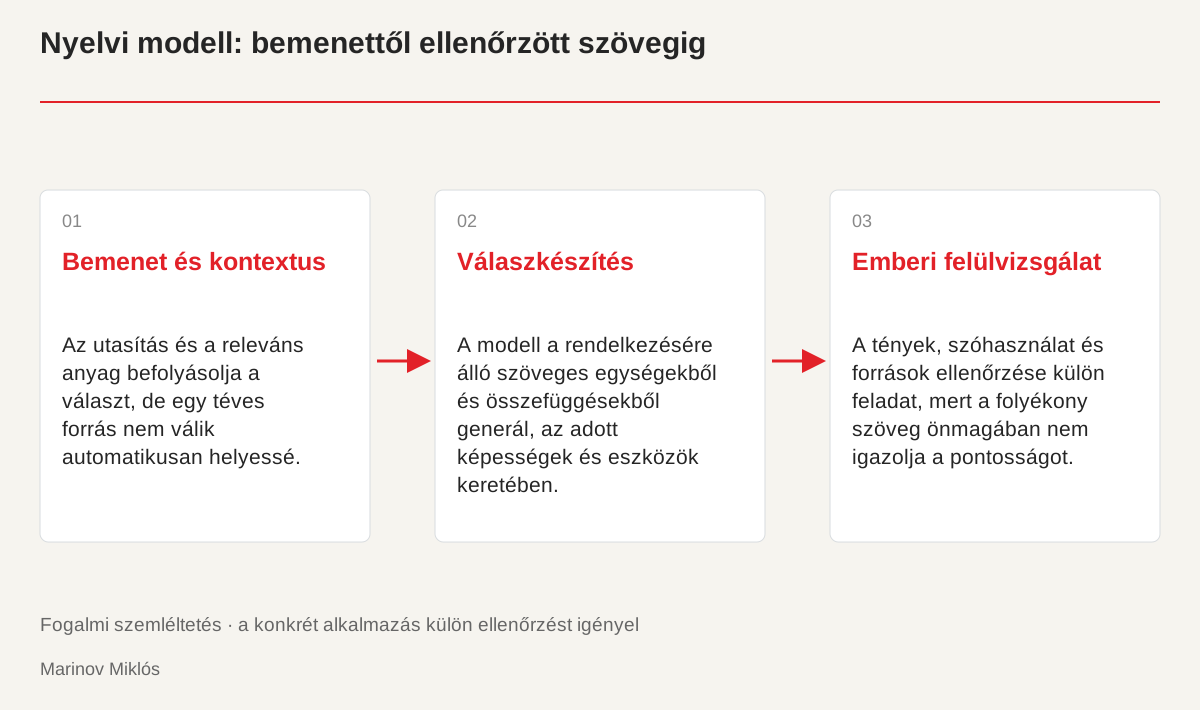
- Bemenet és kontextus: Az utasítás és a releváns anyag befolyásolja a választ, de egy téves forrás nem válik automatikusan helyessé.
- Válaszkészítés: A modell a rendelkezésére álló szöveges egységekből és összefüggésekből generál, az adott képességek és eszközök keretében.
- Emberi felülvizsgálat: A tények, szóhasználat és források ellenőrzése külön feladat, mert a folyékony szöveg önmagában nem igazolja a pontosságot.
Használat a tervezési munkában
Ötleteléshez, vázlatokhoz és szövegváltozatokhoz értékes segítség lehet, de a végleges tartalomért továbbra is ember felel. Ellenőrizd a tényeket, a jogokat, az érzékeny adatokat és a saját hangvételt. Külső keresőeszköz vagy dokumentum-visszakeresés bővítheti a rendelkezésre álló információt, de nem teszi automatikusan hibátlanná a választ. Az AI akkor használható jól, ha a cél és az ellenőrzés is világos.
A tanítás és a válaszadás két külön folyamat
A tanítás során a modell paraméterei módosulnak az adatok és a tanítási cél alapján. Egy szokásos beszélgetés közben ezzel szemben a modell a rendelkezésére álló bemenetből állít elő választ; a kérdés megírása nem azonos egy új modell betanításával. A kontextus megváltoztathatja a kimenetet, de ezt ne keverd a tanult paraméterek tartós változásával. Egy céges szóhasználati útmutató bemásolása például segíthet az adott szöveg megformálásában. Ettől nem következik automatikusan, hogy minden más beszélgetésben ugyanaz a személyes útmutató rendelkezésre áll majd.
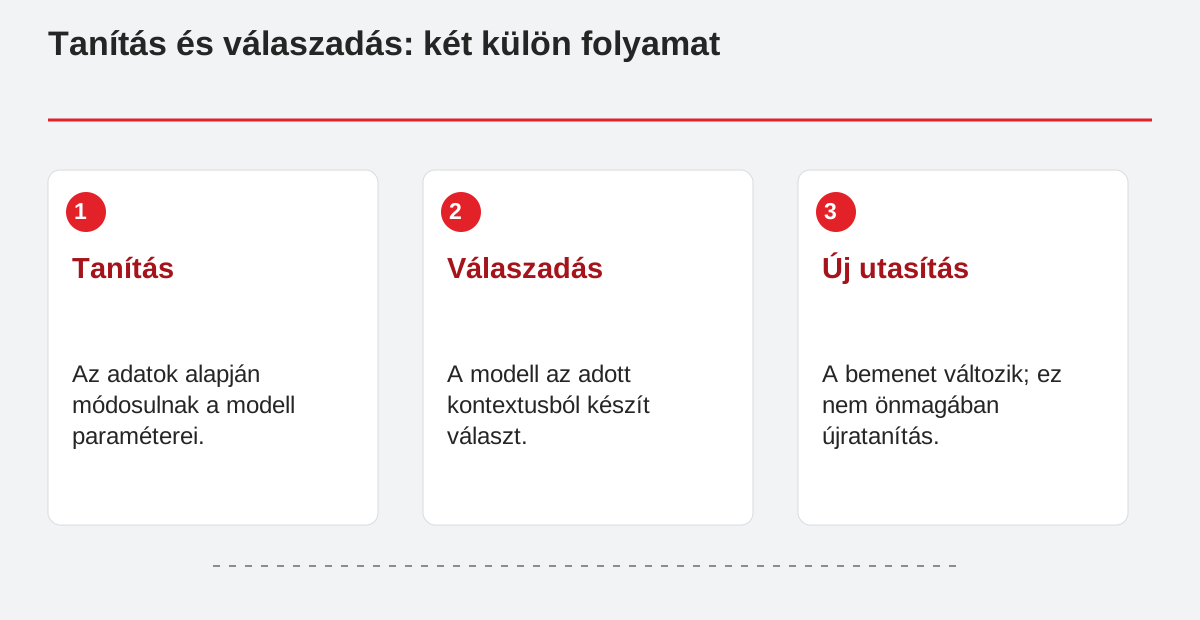
Tanítás és válaszadás: két külön folyamat.
- Tanítás: Az adatok alapján módosulnak a modell paraméterei.
- Válaszadás: A modell az adott kontextusból készít választ.
- Új utasítás: A bemenet változik; ez nem önmagában újratanítás.
Miért fontos a token fogalma?
A modell nem egyszerűen szólistaként kezeli a mondatot. A tokenizálás kisebb egységekre bontja a szöveget, amelyek lehetnek szórészek vagy más szövegrészletek is. A konkrét felbontás a tokenizálótól függ, ezért a szavak vagy karakterek száma nem mindig jó helyettesítője a tokenek számának. Egy magyar, német és angol változat eltérő mennyiségű egységet igényelhet. Ez a hosszú dokumentumok feldolgozásánál és az elérhető kontextus tervezésénél számít. A szemléltető ábra fogalmi folyamatot mutat, nem egy adott termék pontos belső adatstruktúráját.
A kontextus segít, de nem tesz mindent igazzá
Az utasítás, a korábbi üzenetek és a hozzáadott anyagok együtt befolyásolhatják a választ. Ha egy szolgáltatásleírásból hiányzik a célközönség, a modell könnyen túl általános szöveget készít. Adj pontos feladatot, szükséges adatot és világos korlátot. Ugyanakkor egy bemásolt téves állítás a válaszban is megjelenhet. A gördülékeny megfogalmazás önmagában nem bizonyítja a válasz pontosságát. A forrás, a számadat és a szakmai összefüggés ellenőrzése külön feladat marad, ezért a végleges publikációt nem érdemes kizárólag a szöveg meggyőző hangja alapján elfogadni.
Az eszközhasználat külön réteg
Egy erre felkészített alkalmazás keresőt, fájlokat vagy más eszközt adhat a modellnek. Ilyenkor a feladat nem csak a tanult mintákból készített szöveg, hanem a rendelkezésre álló adatok és műveletek használata is lehet. Az eszköz eredménye azonban lehet hiányos, régi vagy félreérthető. Egy megtalált weboldal címének megemlítése még nem jelenti, hogy az oldal valóban alátámasztja az állítást. A keresési találatot és a tényleges forrást külön nézd meg. A konkrét képességeket mindig az adott modell és alkalmazás dokumentációjából ellenőrizd.
Példa egy tervezési munkafolyamatra
Egy weboldal bevezetőjéhez először add meg a valódi szolgáltatást, a látogató helyzetét és a kívánt hangvételt. Kérj néhány változatot, majd hasonlítsd őket a célhoz. A választott irányt a saját szóhasználatoddal és tényeiddel dolgozd tovább. Fordításnál ellenőrizd a neveket, a szakkifejezéseket és a belső linkeket, ne csak a mondatok nyelvtanát. A modell így vázlatot és összehasonlítási lehetőséget ad, nem helyettesíti a szerkesztői döntést. Egy jó végleges szövegnek a vállalkozás tényleges működéséhez kell illeszkednie, nem pusztán jól hangzó általánosságokat sorolnia.
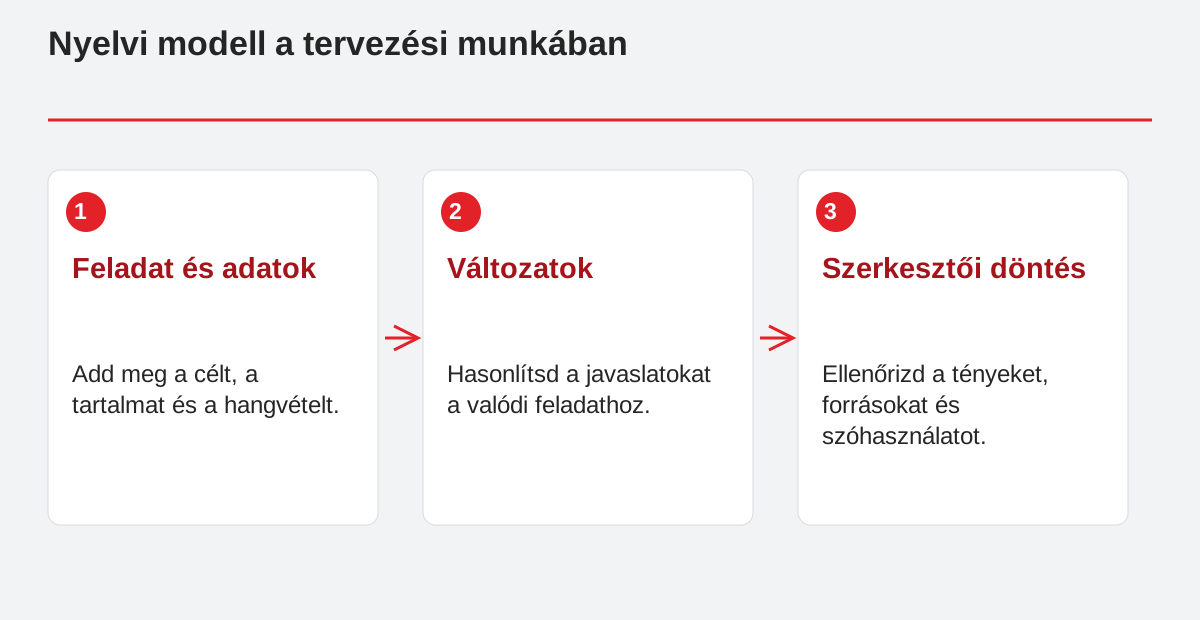
Nyelvi modell a tervezési munkában.
- Feladat és adatok: Add meg a célt, a tartalmat és a hangvételt.
- Változatok: Hasonlítsd a javaslatokat a valódi feladathoz.
- Szerkesztői döntés: Ellenőrizd a tényeket, forrásokat és szóhasználatot.
Válaszminőség és következetes ellenőrzés
Ha rendszeresen ugyanarra a feladatra használod, gyűjts néhány reprezentatív próbát. Legyen közöttük egyszerű eset, hiányos bemenet és olyan kérdés, amelynél bizonytalanságot kell jelezni. A szöveg megfelelőségét ezekkel vizsgáld, ne egyetlen sikeres válaszból indulj ki. Az ellenőrzés célja a hibák felismerése, nem a modell hibátlanságának bizonyítása. Az OpenAI hivatalos dokumentációja is külön feladatként kezeli az értékelést és az eredmények javítását. A saját munkában ez jelenthet rövid ellenőrzőlistát a tényekről, a hangvételről, a formátumról és a források helyességéről.
Az adatokkal tudatosan bánj
Csak olyan anyagot használj, amelynek kezelésére jogosult vagy, és amely szükséges a feladathoz. Ügyféladat, belső dokumentum vagy hozzáférési titok nem kerülhet automatikusan minden kérdésbe. Vizsgáld az alkalmazott szolgáltatás tényleges beállításait és adatkezelési feltételeit, ne általános feltételezésre építs. A modell által készített szöveg vagy kód pedig csak ellenőrzés után kerüljön éles használatba. A jó feladatleírás, az érthető kontextus és az emberi felülvizsgálat együtt teszi a nyelvi modellt hasznos segédeszközzé a tervezésben és a tartalomkészítésben.
További szakmai források
Kapcsolódó olvasnivaló
Vektoros adatbázisok: keresés jelentés és hasonlóság alapján