
Vektoros adatbázisok: keresés jelentés és hasonlóság alapján
Archív bejegyzés, szerkesztett tartalommal
Miért keresünk jelentés alapján?
A vektoros keresés olyan számsorokkal dolgozik, amelyek szövegek, képek vagy más adatok jellemzőit reprezentálják. Az embedding, vagyis beágyazás lehetővé teszi, hogy ne csak pontos kulcsszóegyezést keressünk, hanem hasonló tartalmakat is megtaláljunk. Ha valaki „könnyen kezelhető üzleti honlapot” keres, a rendszer egy „átlátható vállalati weboldalról” szóló leírást is a találati lista elejére sorolhat. Ez lehetséges találat, nem garantált értelmezés: a minőség a választott modelltől és az adatoktól függ.
Az embedding nem maga a dokumentum
A beágyazási modell egy szövegrészletből meghatározott hosszúságú vektort készít. Az egyes koordináták rendszerint nem olvashatók egyszerű címkékként, például „ár” vagy „minőség”. Az összehasonlítható kérdéseknek és dokumentumoknak egymással kompatibilis vektortérben kell megjelenniük. Különböző modellek azonos hosszúságú vektorai sem feltétlenül hasonlíthatók össze. A dokumentum eredeti szövegét, azonosítóját és forrását ezért a vektor mellett is megőrizzük; a vektor nem helyettesíti az ellenőrizhető tartalmat.
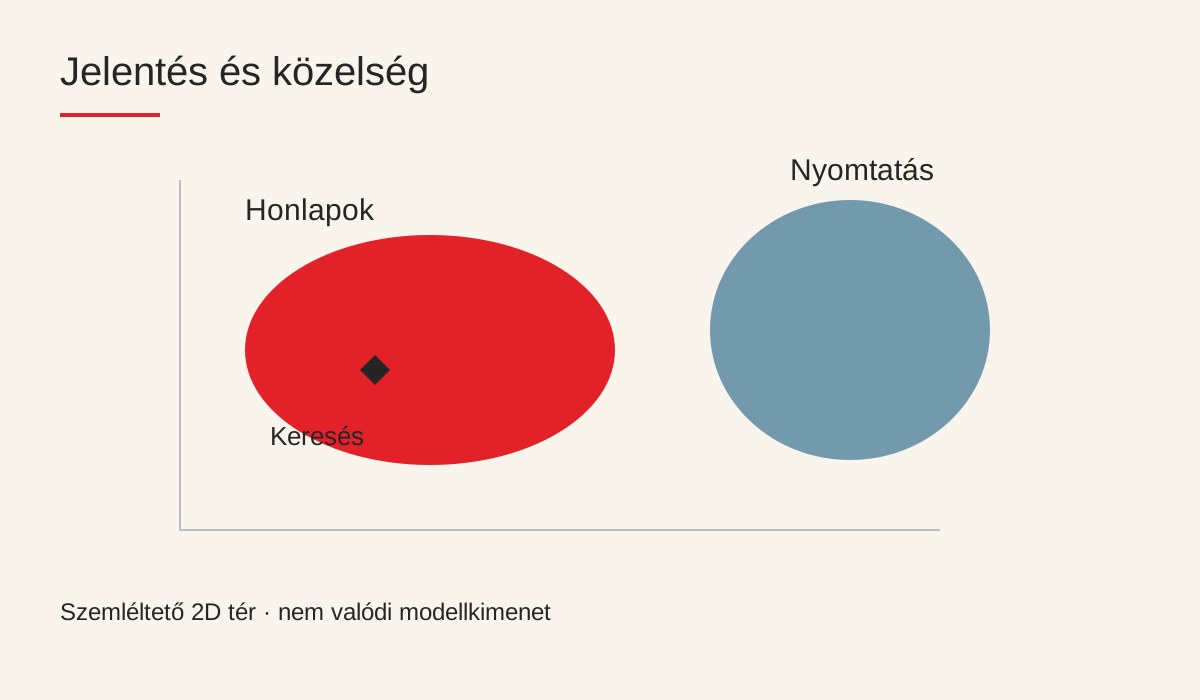
Szemléltető 2D tér · nem valódi modellkimenet
Hasonlóság: a mérőszám is számít
A koszinuszos hasonlóság a vektorok irányát hasonlítja össze. Azonos iránynál az érték 1, merőleges iránynál 0; a koszinuszos távolság ezekből 1 mínusz hasonlóságként számolható. Más feladatnál euklideszi távolság vagy skalárszorzat lehet megfelelő. A modellhez ajánlott mérőszámot kell választani. Egy 0,8-as pontszám nem jelenti azt, hogy a találat „80%-ban igaz”, és eltérő modellek pontszámaihoz nem érdemes közös, önkényes küszöböt rendelni.
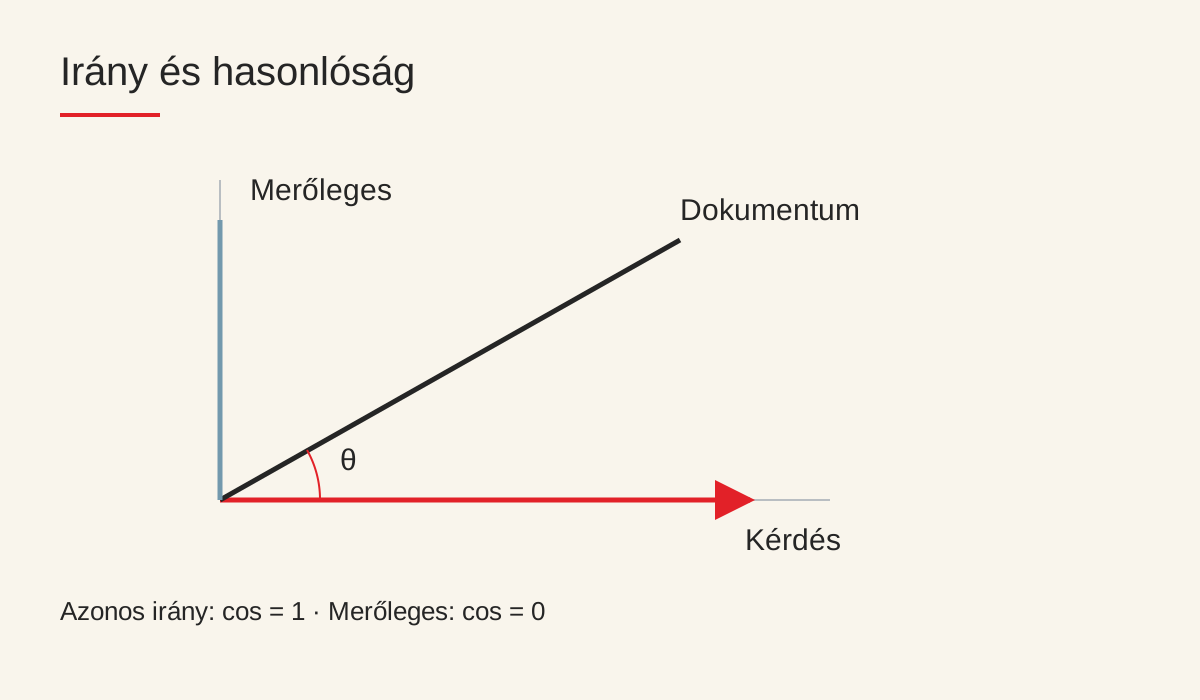
Azonos irány: cos = 1 · Merőleges: cos = 0
Hogyan lesz a tartalomból kereshető gyűjtemény?
Hosszabb dokumentumokat értelmes, kezelhető részletekre bontunk, és mindegyikhez vektort, forráshivatkozást, nyelvet és hozzáférési adatokat rendelünk. A kérdésből ugyancsak vektor készül, majd a rendszer megkeresi a legközelebbi találatokat. Egy ügyfélszolgálati tudástárban így egy hétköznapi kérdéshez a megfelelő útmutatórészlet kapcsolódhat. A túl rövid részlet elveszítheti a kontextust, a túl hosszú pedig összemoshat több témát. A darabolás minőségét valós kérdésekkel érdemes tesztelni.
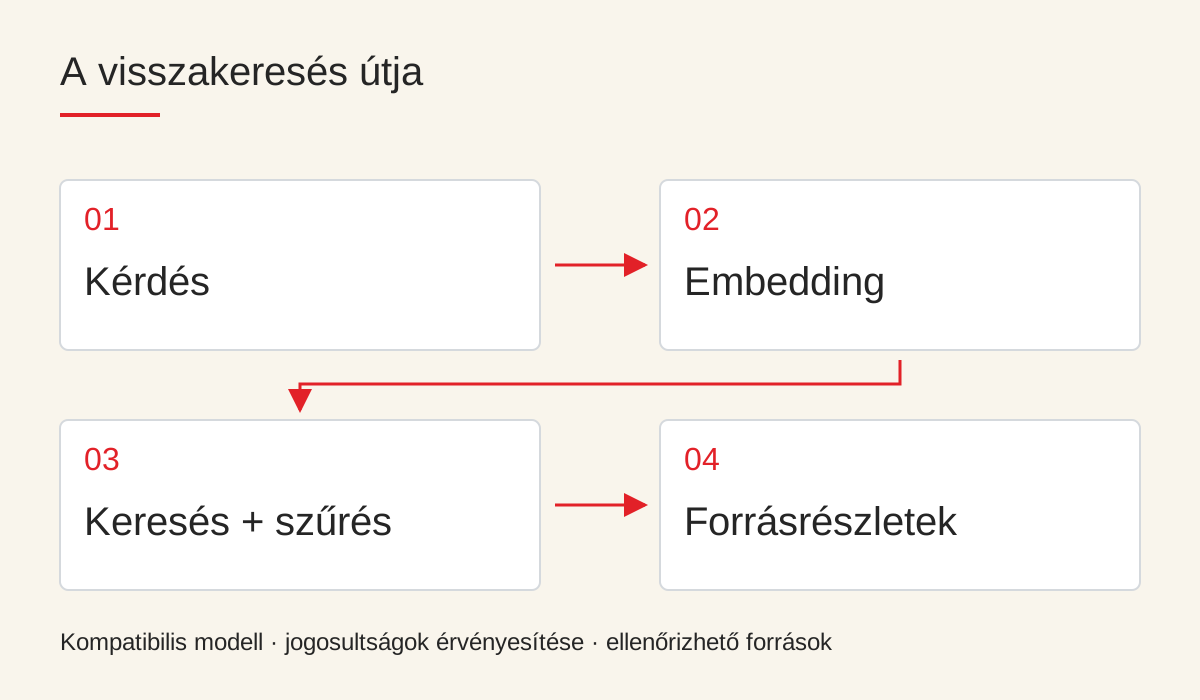
Kompatibilis modell · jogosultságok érvényesítése · ellenőrizhető források
Kulcsszó és jelentés együtt
Termékkódok, személynevek vagy pontos jogszabályszámok esetén a kulcsszavas keresés továbbra is fontos. A hibrid keresés a szöveges és vektoros találatokat közös rangsorba rendezheti, szükség esetén külön újrarangsorolással. A nyelv, a dátum vagy a termékkategória szerinti szűrés más feladat, mint a hasonlósági pontszám kiszámítása. A hozzáférési jogosultság pedig nem puszta kényelmi szűrő: illetéktelen dokumentum sem találatként, sem későbbi AI-válasz forrásaként nem kerülhet a felhasználó elé.
Kiegészítés, nem minden adatbázis leváltása
A hagyományos adatbázisok összetett adatokat és képeket is kezelhetnek. A vektorfunkció külön szolgáltatás vagy egy meglévő rendszer része lehet, például PostgreSQL és pgvector használatával. Kis gyűjteménynél a pontos, közelítés nélküli keresés is elég lehet; nagyobb adathalmaznál egy közelítő index gyorsíthat, de releváns találatokat hagyhat ki. Az index kiválasztása ezért sebesség, memória és visszakeresési minőség közötti döntés. Mérjünk késleltetést és relevanciát, ne kizárólag egy látványos demó alapján válasszunk.
Mit jelent ez egy AI-alkalmazásban?
A RAG-megközelítés visszakeresett dokumentumrészleteket ad kontextusként egy nyelvi modellnek. Nem azonos a modell újratanításával, és nem garantál tévedésmentes választ. Egy jól tervezett rendszer megmutatja a forrásokat, kezeli a kevésbé biztos találatokat, és ellenőrzi a jogosultságokat. Az elavult tartalmakat frissíteni vagy törölni kell az indexből is. Modellváltáskor új beágyazások készítésére lehet szükség. A valódi cél az, hogy a látogató gyorsabban jusson megbízható, számára hozzáférhető információhoz.