
Vektordatenbanken: Suche nach Bedeutung und Ähnlichkeit
Archivbeitrag mit redaktionell überarbeitetem Inhalt
Warum nach Bedeutung suchen?
Vektorsuche arbeitet mit Zahlenfolgen, die Eigenschaften von Texten, Bildern oder anderen Daten repräsentieren. Embeddings ermöglichen ähnliche Treffer auch ohne identische Schlüsselwörter. Wer eine „leicht bedienbare Firmenwebsite“ sucht, könnte eine Beschreibung einer „übersichtlichen Unternehmensseite“ finden. Das ist eine mögliche Zuordnung, keine garantierte Interpretation. Die Qualität hängt vom Modell und den Daten ab; Ähnlichkeit allein beweist weder Richtigkeit noch Eignung für einen bestimmten Auftrag.
Das Embedding ist nicht das Dokument
Ein Embedding-Modell erzeugt aus einem Textabschnitt einen Vektor fester Länge. Seine Koordinaten lassen sich meist nicht als einfache Merkmale wie „Preis“ oder „Qualität“ lesen. Fragen und Dokumente müssen in einem kompatiblen Repräsentationsraum liegen. Gleiche Dimensionen machen Vektoren verschiedener Modelle noch nicht vergleichbar. Originaltext, Kennung und Quelle bleiben deshalb neben dem Vektor erhalten. Nur so lässt sich ein Treffer nachvollziehen und bei Bedarf korrigieren.
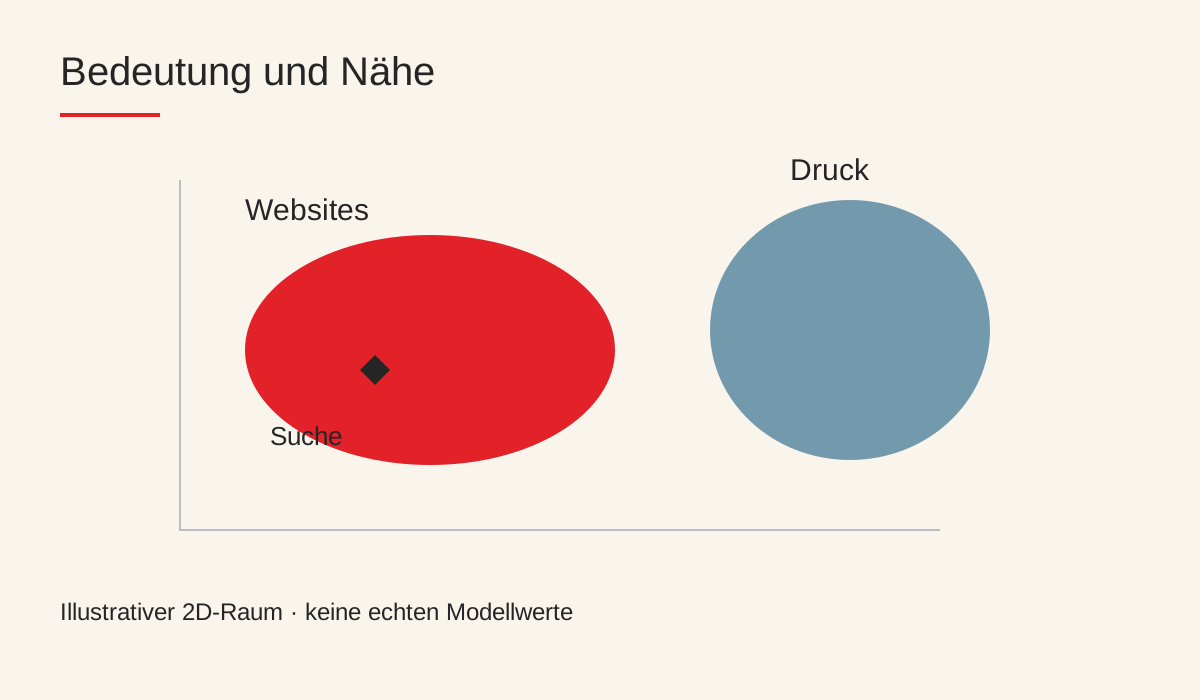
Illustrativer 2D-Raum · keine echten Modellwerte
Ähnlichkeit braucht eine passende Metrik
Kosinusähnlichkeit vergleicht die Richtung von Vektoren: gleiche Richtung ergibt 1, senkrechte Richtungen ergeben 0. Kosinusdistanz lässt sich als 1 minus Ähnlichkeit berechnen. Je nach Modell sind euklidische Distanz oder Skalarprodukt geeigneter. Verwende die zum Modell passende Metrik. Ein Wert von 0,8 bedeutet nicht „zu 80 Prozent wahr“. Ein gemeinsamer willkürlicher Schwellenwert für unterschiedliche Modelle kann wichtige Treffer aussortieren oder ungeeignete bevorzugen.
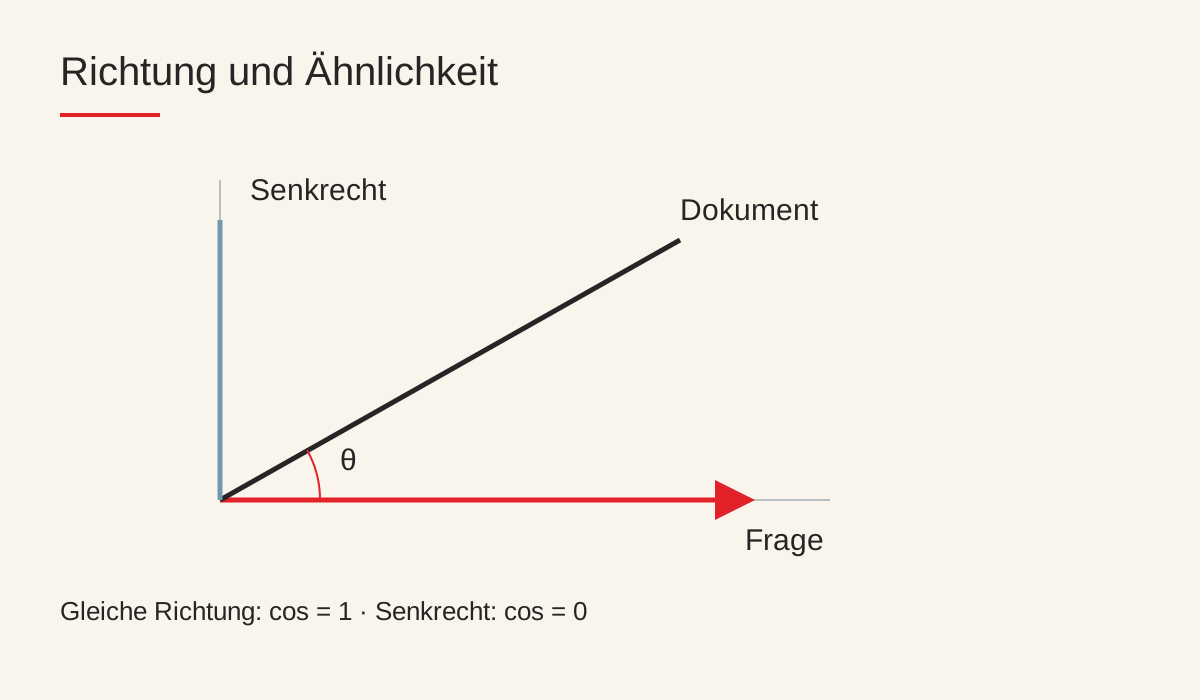
Gleiche Richtung: cos = 1 · Senkrecht: cos = 0
Vom Inhalt zur durchsuchbaren Sammlung
Längere Dokumente werden in sinnvolle Abschnitte aufgeteilt. Jeder Abschnitt erhält einen Vektor, einen Quellenverweis sowie Angaben zu Sprache und Zugriffsrechten. Auch die Suchfrage wird eingebettet; anschließend werden ähnliche Abschnitte gesucht. In einer Support-Wissensbasis kann eine alltägliche Frage so zum passenden Anleitungsteil führen. Zu kleine Abschnitte verlieren Kontext, zu große vermischen Themen. Teste diese Aufteilung deshalb mit echten Fragen und überprüfbaren erwarteten Treffern.
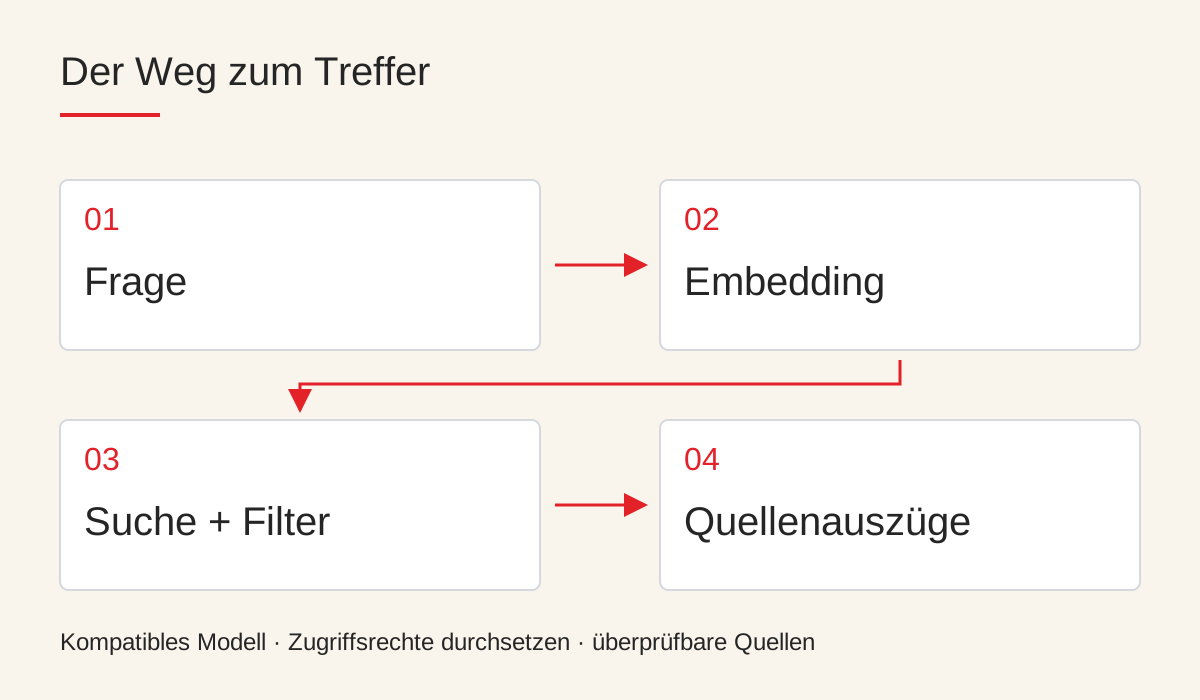
Kompatibles Modell · Zugriffsrechte durchsetzen · überprüfbare Quellen
Schlüsselwörter und Bedeutung kombinieren
Für Artikelnummern, Eigennamen und genaue Vorschriften bleiben Schlüsselwörter wichtig. Hybride Suche kann lexikalische und vektorbasierte Treffer zusammenführen und anschließend neu bewerten. Sprache, Datum oder Kategorie sind zusätzliche Filter, keine Ähnlichkeitsmetriken. Zugriffsrechte müssen bereits bei der Auswahl durchgesetzt werden: Ein fremdes Kundendokument darf weder als Suchtreffer noch als Kontext einer späteren KI-Antwort offengelegt werden. Eine sichtbare Sperre im Browser reicht dafür nicht aus.
Ergänzung statt universeller Ersatz
Herkömmliche Datenbanken verwalten ebenfalls komplexe Daten und Bilder. Vektorfunktionen können als eigener Dienst oder Erweiterung eingesetzt werden, beispielsweise mit PostgreSQL und pgvector. Für kleine Sammlungen genügt möglicherweise exakte Suche. Ein approximativer Index kann größere Bestände schneller durchsuchen, dabei aber relevante Nachbarn übersehen. Geschwindigkeit, Speicherbedarf und Trefferqualität müssen gemeinsam bewertet werden. Eine überzeugende Vorführung ersetzt keinen Test mit den eigenen Inhalten und typischen Suchanfragen.
Was bedeutet das für eine KI-Anwendung?
RAG stellt einem Sprachmodell gefundene Dokumentabschnitte als Kontext bereit. Das ist kein erneutes Modelltraining und garantiert keine fehlerfreien Antworten. Ein brauchbares System nennt Quellen, behandelt unsichere Treffer und schützt vertrauliche Inhalte. Änderungen und Löschungen müssen auch im Index ankommen. Ein Modellwechsel kann neue Embeddings erfordern. Entscheidend ist, ob Besucher verlässliche, zugängliche Informationen schneller finden; dafür sollten Relevanz und Fehler regelmäßig überprüft werden.