

Wie funktioniert ChatGPT? Das Sprachmodell hinter den Antworten
Archivbeitrag mit redaktionell überarbeitetem Inhalt
Sprachmodelle hinter ChatGPT lernen sprachliche Muster und erzeugen anhand des vorliegenden Kontexts Antworten. Sie suchen nicht einfach vorbereitete Sätze in einer Datenbank. Fähigkeiten hängen vom eingesetzten Modell und verfügbaren Werkzeugen ab; eine Beschreibung einer alten GPT-Version erklärt nicht den gesamten heutigen Dienst.
Tokens, Transformer und Aufmerksamkeit
Text wird in Tokens aufgeteilt, also kleinere Texteinheiten, die nicht zwingend ganze Wörter sind. Eine grundlegende Trainingsaufgabe der GPT-Familie ist die Vorhersage des nächsten Tokens. Der Aufmerksamkeitsmechanismus eines Transformers lernt Beziehungen zwischen Teilen des Kontexts. Gewichte aus Query-, Key- und Value-Projektionen geben Informationen unterschiedliche Bedeutung; mehrere Attention-Heads können verschiedene Beziehungen erfassen. Klassische GPT-Beschreibungen beruhen auf einer Decoder-Architektur. Es ist deshalb ungenau zu behaupten, jedes GPT-Modell besitze einen vollständigen separaten Encoder und Decoder.
Training und menschliche Rückmeldung
Vortraining lernt allgemeine Muster aus großen Datenmengen. Nachtraining und Rückmeldungen können das Befolgen von Anweisungen, Nützlichkeit und Sicherheit verbessern. Gelernte Parameter bedeuten jedoch nicht, dass jede Antwort verstanden oder geprüft wurde. Flüssiger Text kann falsche Schlüsse und erfundene Quellen enthalten.
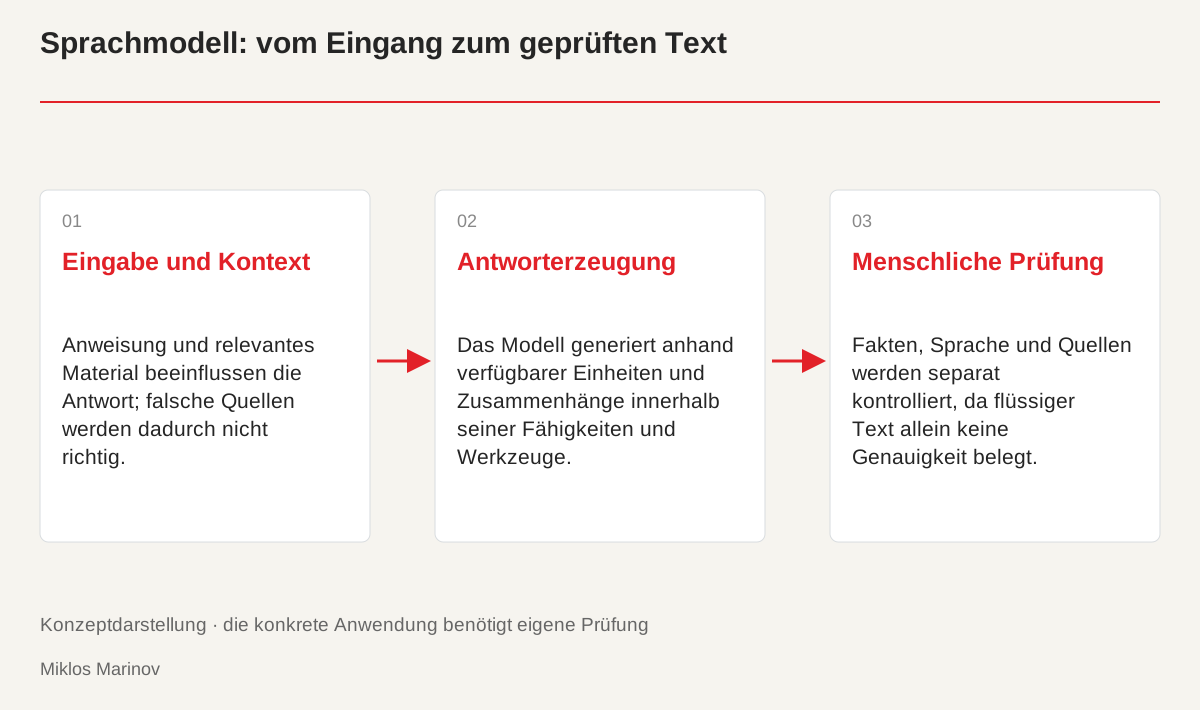
- Eingabe und Kontext: Anweisung und relevantes Material beeinflussen die Antwort; falsche Quellen werden dadurch nicht richtig.
- Antworterzeugung: Das Modell generiert anhand verfügbarer Einheiten und Zusammenhänge innerhalb seiner Fähigkeiten und Werkzeuge.
- Menschliche Prüfung: Fakten, Sprache und Quellen werden separat kontrolliert, da flüssiger Text allein keine Genauigkeit belegt.
Anwendung in der Gestaltung
Für Ideen, Entwürfe und Textvarianten kann das Werkzeug hilfreich sein; für das endgültige Ergebnis bleibt ein Mensch verantwortlich. Prüfe Fakten, Rechte, sensible Daten und den eigenen Ton. Suche oder Dokumentenabruf können die Informationsgrundlage erweitern, machen eine Antwort aber nicht automatisch fehlerfrei. Klare Ziele und überprüfbare Ergebnisse sind entscheidend.
Training und Antworten sind unterschiedliche Vorgänge
Beim Training werden Modellparameter anhand von Daten und Lernziel verändert. In einem gewöhnlichen Gespräch erzeugt das Modell dagegen eine Antwort aus dem verfügbaren Eingang. Eine Frage zu stellen ist nicht dasselbe wie ein neues Modell zu trainieren. Kontext kann die Ausgabe verändern, sollte aber nicht mit einer dauerhaften Veränderung der gelernten Parameter verwechselt werden. Eine eingefügte Sprachrichtlinie kann beispielsweise den aktuellen Text beeinflussen. Daraus folgt nicht automatisch, dass dieselbe persönliche Anleitung in allen anderen Gesprächen verfügbar bleibt. Diese Unterscheidung hilft, Erwartungen an Anpassung und Erinnerung präziser zu formulieren.
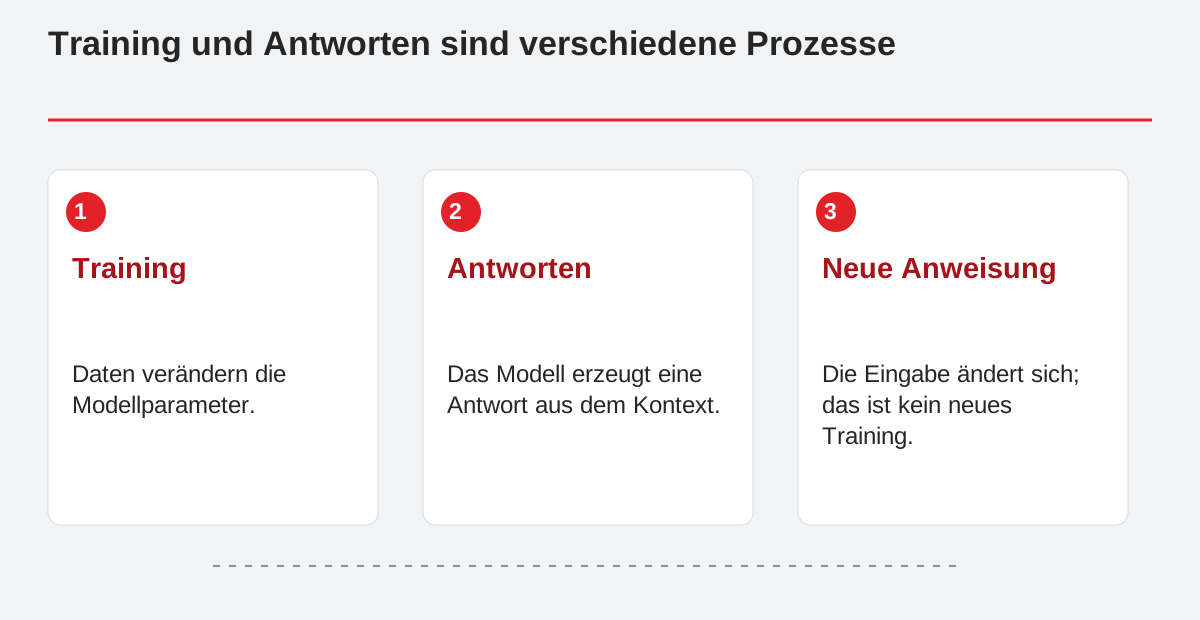
Training und Antworten sind verschiedene Prozesse.
- Training: Daten verändern die Modellparameter.
- Antworten: Das Modell erzeugt eine Antwort aus dem Kontext.
- Neue Anweisung: Die Eingabe ändert sich; das ist kein neues Training.
Weshalb Tokens wichtig sind
Das Modell behandelt einen Satz nicht einfach als Wortliste. Die Tokenisierung zerlegt Text in kleinere Einheiten, darunter Wortteile oder andere Abschnitte. Die konkrete Zerlegung hängt vom Tokenizer ab. Wörter und Zeichen sind deshalb nicht immer geeignete Ersatzwerte für die Tokenzahl. Ungarische, deutsche und englische Fassungen können unterschiedliche Mengen benötigen. Das beeinflusst die Verarbeitung längerer Dokumente und die Planung des verfügbaren Kontexts. Die Illustration zeigt einen begrifflichen Ablauf, nicht die genaue interne Datenstruktur eines bestimmten Produkts. Für konkrete Grenzen muss die Dokumentation des tatsächlich eingesetzten Modells herangezogen werden.
Kontext hilft, garantiert aber keine Wahrheit
Anweisung, frühere Nachrichten und beigefügte Materialien können die Antwort gemeinsam beeinflussen. Fehlt bei einer Leistungsbeschreibung die Zielgruppe, wird der Text leicht zu allgemein. Gib Aufgabe, notwendige Daten und klare Grenzen an. Eine eingefügte falsche Behauptung kann jedoch ebenfalls in die Antwort gelangen. Sprachliche Flüssigkeit ist kein Qualitätsnachweis. Quellen, Zahlen und fachliche Zusammenhänge müssen separat geprüft werden. Veröffentliche deshalb nicht allein aufgrund eines überzeugenden Tons. Gute Eingaben erleichtern die Arbeit, nehmen dem Redakteur aber nicht die Verantwortung für die Aussage des fertigen Texts ab.
Werkzeuge bilden eine zusätzliche Ebene
Eine entsprechend vorbereitete Anwendung kann Suche, Dateien oder andere Werkzeuge bereitstellen. Die Aufgabe kann dann auch das Verwenden verfügbarer Daten und Aktionen umfassen statt ausschließlich Text aus gelernten Mustern zu erzeugen. Werkzeugergebnisse können trotzdem unvollständig, veraltet oder missverständlich sein. Das Erwähnen eines gefundenen Seitentitels beweist nicht, dass die Quelle die Behauptung stützt. Prüfe Suchtreffer und tatsächliches Dokument getrennt. Konkrete Möglichkeiten gehören zur Dokumentation von Modell und Anwendung. Eine im anderen Produkt verfügbare Funktion darf nicht automatisch für die aktuell verwendete Umgebung vorausgesetzt werden.
Beispiel aus einem Gestaltungsprozess
Gib für einen Websiteauftakt tatsächliche Leistung, Besuchersituation und gewünschte Sprache an. Lass mehrere Varianten entstehen und vergleiche sie mit dem Ziel. Überarbeite die gewählte Richtung mit eigenen Begriffen und Fakten. Kontrolliere bei Übersetzungen Namen, Fachsprache und interne Links statt nur Grammatik. Das Modell liefert Entwürfe und Vergleichsmöglichkeiten, ersetzt aber keine redaktionelle Entscheidung. Ein guter endgültiger Text muss zum realen Unternehmen passen. Allgemeine Aussagen, die zwar gut klingen, aber die angebotene Arbeit nicht erklären, werden durch automatische Erzeugung nicht hilfreicher. Die Bearbeitung verbindet das Werkzeugergebnis mit dem tatsächlichen Inhalt.
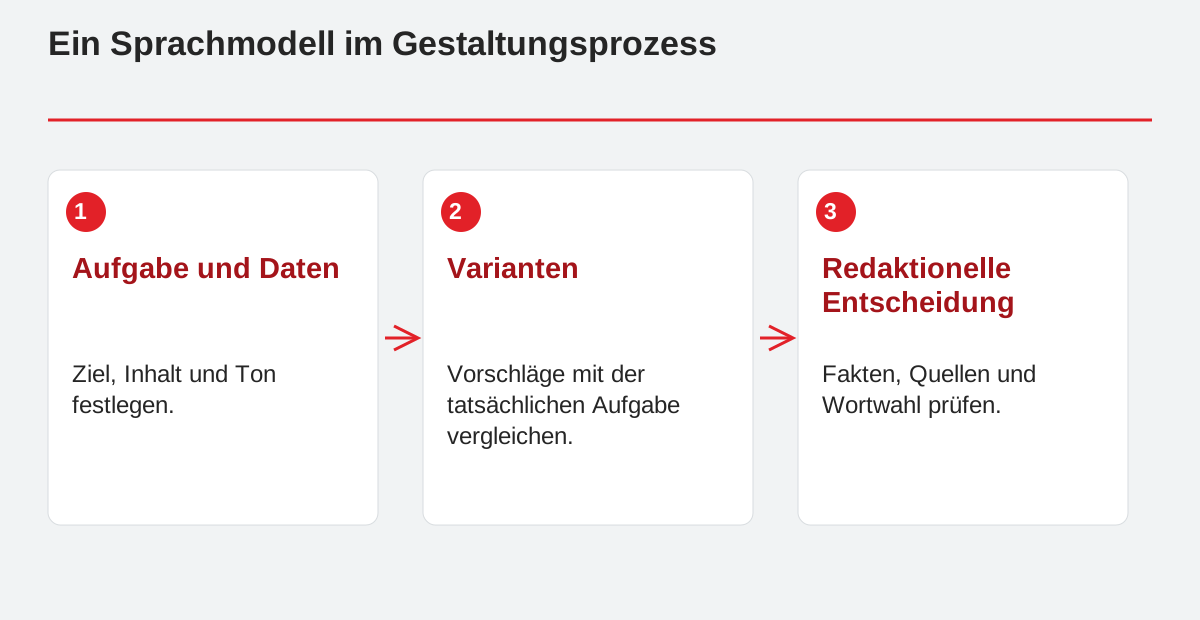
Ein Sprachmodell im Gestaltungsprozess.
- Aufgabe und Daten: Ziel, Inhalt und Ton festlegen.
- Varianten: Vorschläge mit der tatsächlichen Aufgabe vergleichen.
- Redaktionelle Entscheidung: Fakten, Quellen und Wortwahl prüfen.
Qualität wiederholbar prüfen
Sammle bei wiederkehrenden Aufgaben repräsentative Tests. Berücksichtige einen einfachen Fall, unvollständige Eingaben und eine Frage, bei der Unsicherheit deutlich werden muss. Beurteile Ergebnisse damit statt anhand einer einzelnen gelungenen Antwort. Die Prüfung soll Fehler finden, nicht Unfehlbarkeit beweisen. Die offizielle OpenAI-Dokumentation behandelt Evaluation und Ergebnisverbesserung als eigenständige Aufgaben. Für die eigene Arbeit kann eine kurze Liste zu Fakten, Sprache, Format und Quellen genügen. Dokumentiere auch, welche Abweichungen auftreten. So lassen sich Eingaben und Arbeitsabläufe gezielt verbessern, ohne eine zufällige gute Formulierung zum Maßstab für alle künftigen Ausgaben zu machen.
Daten bewusst verwenden
Verwende nur Material, zu dessen Verarbeitung du berechtigt bist und das für die Aufgabe gebraucht wird. Kundendaten, interne Dokumente oder Zugangsschlüssel gehören nicht automatisch in jede Frage. Prüfe tatsächliche Einstellungen und Datenbedingungen des eingesetzten Dienstes statt von allgemeinen Annahmen auszugehen. Generierte Texte und Code benötigen vor produktivem Einsatz eine Kontrolle. Klare Aufgaben, verständlicher Kontext und menschliche Prüfung machen das Modell gemeinsam zu einem hilfreichen Werkzeug für Gestaltung und Inhalte. Die Technik unterstützt Entscheidungen, sollte aber Verantwortung und sorgfältigen Umgang mit den benötigten Informationen nicht unsichtbar machen.